Tesseract OCR
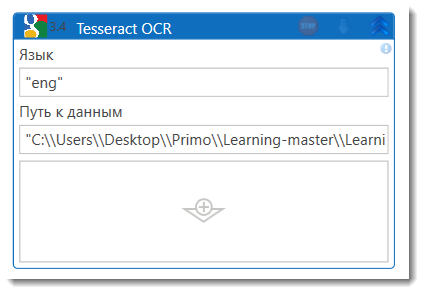
Компонент подключается к ядру OCR Tesseract и позволяет настраивать параметры распознавания текста.
Свойства
Символ * в названии свойства указывает на обязательность заполнения. Описание общих свойств см. в разделе Свойства элемента.
| Свойство | Тип | Описание |
|---|---|---|
| Набор данных | String | Набор данных для распознавания текста. Доступны варианты Best, Fast и Legacy_NOLSTM. |
| Путь к данным | String | Путь к каталогу с данными для распознавания. Если данные отсутствуют, они могут быть загружены автоматически. |
| Режим распознавания | String | Режим распознавания текста. Доступны варианты Legacy и Tesseract 5. |
| Режим сегментации | String | Способ сегментации изображения перед распознаванием. Доступны варианты Авто (PSM 3), Разрозненный текст (PSM 11) и Одна колонка (PSM 4). |
| Язык* | String | Язык распознаваемого текста. Например, rus, eng. Для распознавания текста на русском и английском языках укажите rus+eng. |
| Масштаб* | Int32 | Коэффициент масштабирования изображения перед распознаванием. |
| Переменная | LTools.OCR.OCRInst | Переменная, в которой сохраняется ссылка на ядро OCR. |
Настройка распознавания
Набор данных
Выберите набор данных в зависимости от требований к распознаванию:
Best– набор данных, ориентированный на качество распознавания.Fast– набор данных, ориентированный на скорость распознавания.Legacy_NOLSTM– набор данных для режима Legacy без использования LSTM.
Режим распознавания
Legacy– устаревший режим распознавания.Tesseract 5– режим распознавания с использованием Tesseract 5.
Режим сегментации
-
Авто (PSM 3)– автоматическая сегментация текста. -
Разрозненный текст (PSM 11)– распознавание разрозненного текста без строгого порядка. -
Одна колонка (PSM 4)– распознавание текста, расположенного в одной колонке.|
Только код (Pure code)
Пример использования элемента в процессе Только код (Pure code):
C#
LTools.OCR.OcrApp app = LTools.OCR.OcrApp.InitTesseract(wf, "Путь
к файлу нейросети", "eng", 2);