Обработать документы
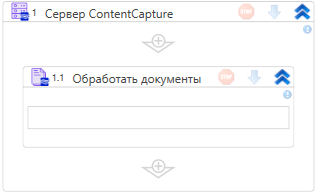
Элемент осуществляет обработку документов на сервере ContentCapture. Подключение к серверу настраивается в контейнере Сервер ContentCapture.
Перед началом работы
Установите в Primo RPA Studio (Windows) пакет Primo.OCR.ContentAI, иначе данный элемент будет недоступен.
Свойства
Символом * отмечены обязательные для заполнения свойства. Описание общих свойств см. здесь.
Обработка:
- Проект* [String] – имя проекта ContentCapture. Пример:
"Project mame". - Пакет* [String] – имя пакета. Пример:
"Primo RPA". - Удалять пакет [Boolean] – определяет, следует ли удалять пакет по завершении обработки. По умолчанию галочка установлена – пакет будет удален.
- Документ [String] – путь к файлу обрабатываемого документа.
- Пакет документов [List<string>] – массив путей к файлам документов.
- Асинхронный [Boolean] – признак асинхронной обработки документов.
- Свойства [List<Dictionary<string, string>>] – свойства документа.
- Таймаут* [Int32] – максимальное время ожидания завершения процесса (мс). По умолчанию
20000. - Использовать User ID [Boolean] – определяет, следует ли использовать User ID. По умолчанию галочка установлена – User ID используется.
- Игнорировать размер [Boolean] – определяет режим отправки данных на сервер. Доступные значения:
галочка отсутствует– значение по умолчанию. Если размер файла меньше 262144(0x40000) байт, то файл будет отправлен на сервер целиком, а если больше – то данные будут разбиты на пакеты.галочка установлена– при любом размере изображения данные на сервер отправятся одним пакетом.
Вывод:
- Результат [Primo.OCR.ContentAI.Model.RecognitionResults] – название переменной, которая будет хранить результат обработки документов.
- Пакет [Primo.OCR.ContentAI.Model.BatchInfo] – название переменной, которая будет хранить информацию о пакете.