Управление моделями на целевой машине
Каждая целевая машина в системе может быть задействована под разные задачи в зависимости от того, как системный администратор выполнил развертывание:
- Машина для AI Текста: позволяет управлять жизненным циклом и конфигурировать инференс LLM-модели на конкретном узле.
- Машина для Агентских систем: открывает доступ к управлению исполнителями конвейеров агентских систем и RAG-серверами.
- Машина для Умного OCR: позволяет обучать и выполнять инференс CV-моделей. В данном разделе при этом осуществляется мониторинг за процессами, позволяя наблюдать за тем, как ресурсы машины распределяются между проектами распознавания в текущий момент.
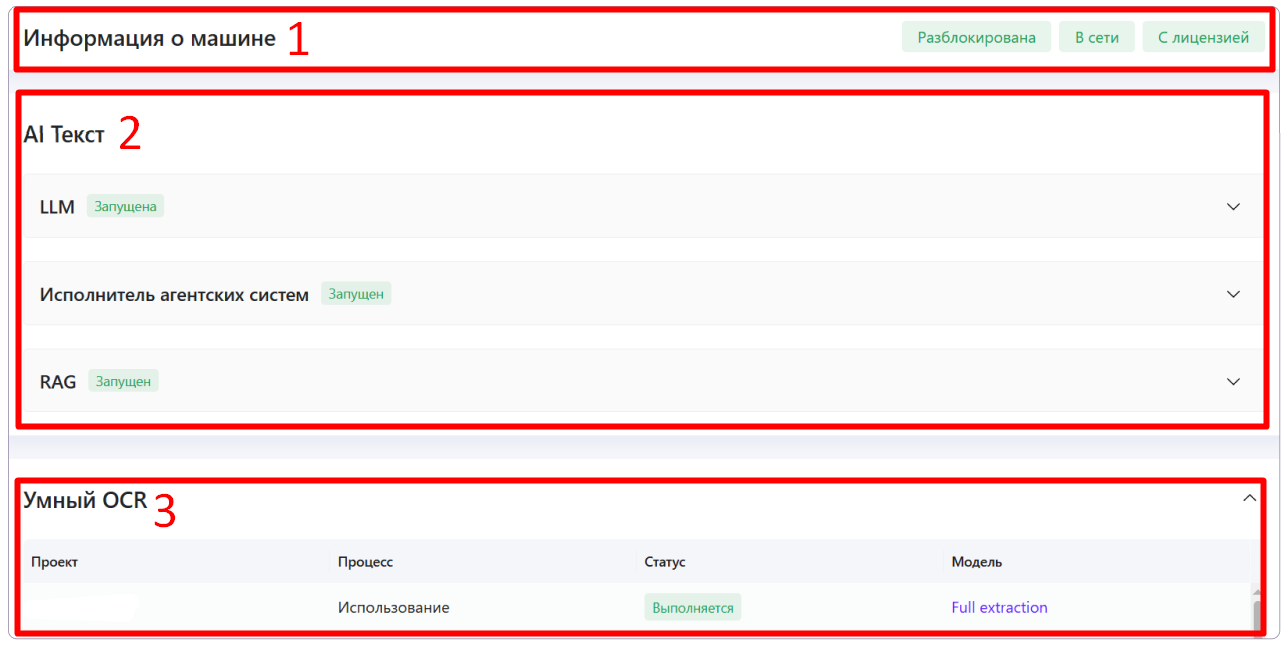
Вверху страницы расположен блок Информация о машине. Ниже слева – меню машины, справа – панель выбранного пункта меню.
Меню разделено на две группы:
- AI Текст:
- LLM – список LLM, добавленных на машину, и кнопка + Добавить LLM;
- Исполнитель агентских систем;
- RAG;
- NLP – сервисы NLP-проектов, работающие на машине.
- Умный OCR – процессы проектов Умного OCR на машине.
Рядом с LLM, исполнителем агентских систем и RAG отображается их текущий статус, например Запущена, Бездействует или Ошибка.
Информация о машине

-
Статус активности машины:
разблокирована– машина удерживает лицензию агента и готова к запуску процессов обучения/инференса в Умном OCR или к запуску LLM-модели в AI Тексте.заблокирована– машина была заблокирована. Это значит, что она освободила лицензию агента и на ней невозможно запустить обучение/инференс в Умном OCR или запустить модель в AI Тексте.
-
Доступность машины для сервера: находится в сети или нет.
-
Наличие действующей лицензии агента: на каждой целевой машине установлен агент, который требует лицензии. Агенты управляет моделью: запускают, настраивают, останавливают, отправляют запросы от сервера. Если отправить запрос на машину без лицензии, то такой запрос завершится ошибкой.
Виджет мониторинга ресурсов машины
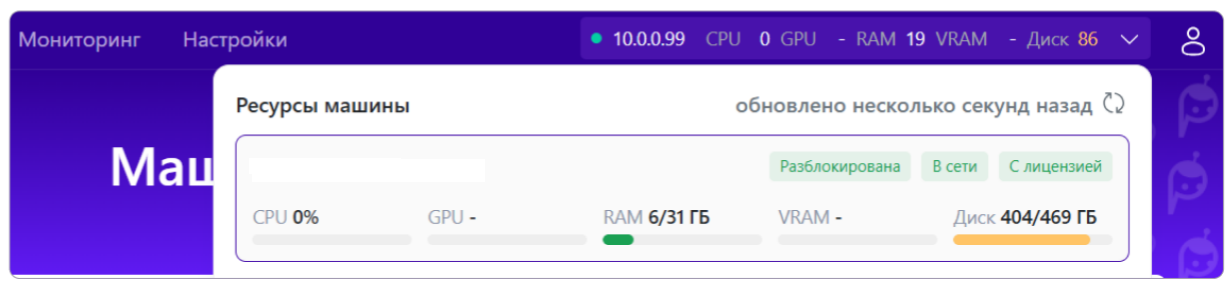
В верхней панели интерфейса отображается компактный виджет с текущей загрузкой машины: CPU, GPU, RAM, VRAM и Диск. При клике виджет разворачивается в панель Ресурсы машины, где показаны:
- Подробные показатели загрузки для текущей машины и её статусные метки.
- Список остальных целевых машин с их адресом и теми же статусными метками, чтобы быстро увидеть, какие машины сейчас доступны, без перехода на страницу Просмотр целевых машин.
Данные в виджете обновляются автоматически (отметка времени вида «обновлено несколько секунд назад»), также доступна кнопка ручного обновления.
AI Текст
Группа меню AI Текст предназначена для конфигурации и запуска больших языковых моделей и работы агентских систем, а также показывает, какие NLP-сервисы работают на машине.
-
LLM
Языковые модели (движки инференса), развернутые на машине. Запущенная LLM используется как модель для сервиса NLP-проекта, как ViT-механизм для Умного OCR или в конвейере Агентских систем. -
Исполнитель агентских систем
Позволяет исполнять и тестировать конвейеры проектов Агентских систем. -
RAG
Позволяет наполнять собственную или внешнюю векторную БД (postgres + pgVector) данными на основе базы знаний, документов и т.д. Используется в конвейерах проектов Агентских систем. -
NLP
Таблица сервисов NLP-проектов, работающих на машине. Только для просмотра: сервис настраивается и запускается в самом проекте, см. NLP.
Текущее состояние
На панели LLM, исполнителя агентских систем и RAG отображается блок Текущее состояние – статус компонента и кнопки управления.
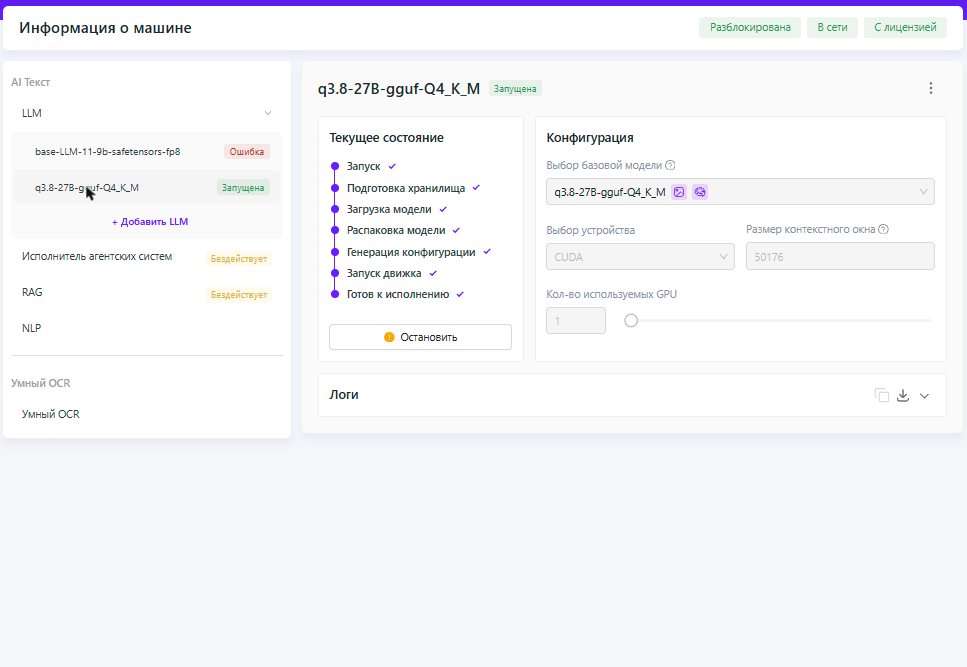
- Статус: показывает текущий режим использования, например
Запущена,Бездействует,Ошибка. Если компонент находится в статусеОшибка, наведите курсор на значок вопроса рядом со статусом: во всплывающей подсказке отобразится причина ошибки. Например, при нехватке видеопамяти подсказка сообщает, сколько памяти доступно, и предлагает увеличить параметр Загруженность видеокарты, %. - Стадии запуска: после нажатия кнопки Запустить отображается пошаговый прогресс инициализации, каждая стадия отмечается галочкой по мере завершения. Набор стадий зависит от типа компонента, например:
- для LLM: Запуск, Подготовка хранилища, Загрузка модели, Распаковка модели, Генерация конфигурации, Запуск движка, Готов к исполнению;
- для Исполнителя агентских систем: Запуск, Подготовка хранилища, Запуск LFX-сервера, Готов к исполнению;
- для RAG: Запуск, Подготовка хранилища, Кэширование rerank-модели, Кэширование embed-модели, Запуск postgres-сервера, Запуск RAG-сервера, RAG-сервер запущен.
- Кнопки управления: кнопка Запустить активирует модель/сервер, а кнопка Остановить прекращает выполнение текущего процесса.
Конфигурация
Конфигурировать можно только бездействующую модель. Настройки нельзя изменять, если модель/сервер уже исполняется. Изменения в полях конфигурации сохраняются автоматически.
Для LLM
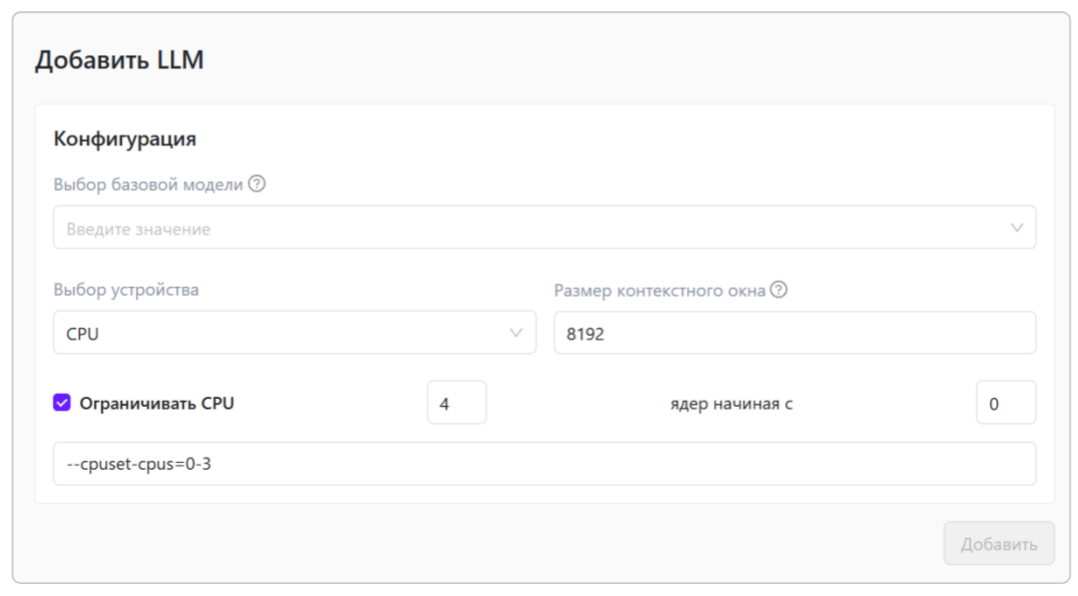
На одной машине можно развернуть несколько LLM: каждая добавляется через + Добавить LLM в меню машины и настраивается независимо. Добавленные LLM отображаются в меню под пунктом LLM.
Чтобы удалить LLM с машины, откройте её, нажмите значок ⋮ в заголовке панели и выберите Удалить.
Параметры конфигурации:
-
Выбор базовой модели: нажмите на поле, чтобы открыть окно Выбор базовой модели, и выберите модель в списке.
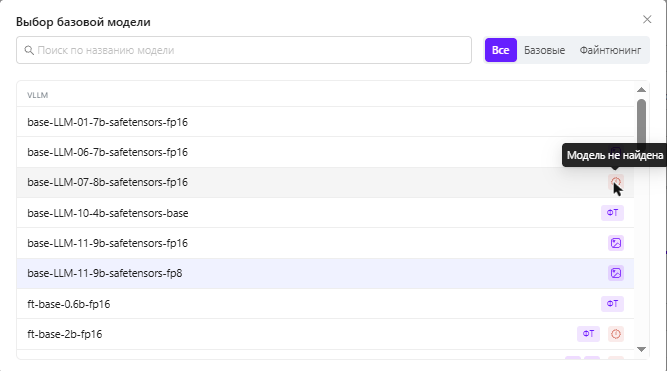
В окне доступны:
- поиск по названию модели;
- фильтр Все / Базовые / Файнтюнинг: Базовые – модели из поставки и добавленные администратором, Файнтюнинг – модели для файнтюнинга и полученные в результате файнтюнинга;
- группировка списка по движку: vLLM и Ollama.
Рядом с названием модели отображаются:
- значки возможностей модели: обработка изображений, рассуждение;
- метка ФТ – модель для файнтюнинга или полученная файнтюнингом. Для модели, обученной в проекте, рядом с меткой указано название проекта;
- красный значок Модель не найдена – файла модели нет ни в хранилище сервера, ни на целевых машинах.
По умолчанию в поставке доступны модели:
Название модели Движок / Размер Тип Описание base-LLM-06-7b-gguf-q8Ollama, 7B Мультимодальная Квантование GGUF q8. Поддерживает текст и изображения, используется как ViT (ранее:base-LLM-05).base-LLM-06-7b-safetensors-fp16vLLM, 7B Мультимодальная Формат safetensors fp16. Рекомендуется для работы с изображениями и ViT (ранее:base-LLM-06).base-LLM-07-8b-safetensors-fp16vLLM, 8B Текстовая Формат safetensors fp16. Дополнительно обучена на фактах русской культуры (ранее:base-LLM-07).base-LLM-06-7b-gguf-fp16Ollama, 7B Мультимодальная Поддерживает изображения (ММ). base-LLM-08-27b-gguf-q4_k_mOllama, 27B Мультимодальная Квантование q4_k_m. Поддержка изображений (ММ).base-LLM-09-30b-gguf-q4_k_mOllama, 30B ММ + Reasoning Квантование q4_k_m. Оптимизирована под рассуждения.base-LLM-11-9b-safetensors-fp16vLLM, 8.7B Мультимодальная Формат safetensors fp16. Распознавание изображений и обработка текста, ViT для Умного OCR. Требует более 14 ГБ VRAM.base-LLM-11-9b-gguf-q4_k_mOllama, 8.7B Мультимодальная Квантование q4_k_m. Распознавание изображений, ViT для Умного OCR. Работает на GPU с 8 ГБ VRAM.base-LLM-11-9b-safetensors-fp8vLLM, 8.7B Мультимодальная Формат safetensors fp8. Распознавание изображений и ViT для Умного OCR.base-LLM-11-30b-gguf-q4_k_mOllama, 30B Мультимодальная Распознавание изображений и ViT для Умного OCR. base-LLM-12-35b-gguf-q4_k_mOllama, 35B ММ + Reasoning Распознавание изображений. Поддерживает рассуждения. base-LLM-12-35b-safetensors-nfvp4vLLM, 35B ММ + Reasoning Формат safetensors. Распознавание изображений и ViT для Умного OCR. Поддерживает рассуждения.base-LLM-13-26b-gguf-q4_k_mOllama, 26B ММ + Reasoning Распознавание изображений. Поддерживает рассуждения. base-LLM-12-35b-safetensors-4bitvLLM, 35B ММ + Reasoning Формат safetensors. Распознавание изображений и ViT для Умного OCR. Поддерживает рассуждения.base-LLM-14-27b-gguf-q4_k_mOllama, 27B ММ + Reasoning Распознавание изображений. Поддерживает рассуждения. base-LLM-14-27b-safetensors-4bitvLLM, 27B ММ + Reasoning Формат safetensors. Распознавание изображений и ViT для Умного OCR. Поддерживает рассуждения.ft-base-0.6b-fp16vLLM, 0.6B Для FT Компактная базовая модель для файнтюнинга. ft-base-2b-fp16vLLM, 2B Для FT Компактная базовая модель для файнтюнинга. -
Размер контекстного окна – предельное количество токенов (текстовых единиц), которые могут быть указаны во входном тексте для обработки. Одно слово на русском языке ~ 2 токена. По умолчанию
4096. -
Выбор устройства – тип устройства, который используется на целевой машине с сервером LLM. Доступные значения:
CPU– значение по умолчанию. Центральный процессор, выполняющий основные операции и управляющий работой компьютера.CUDA– архитектура CUDA позволяет использовать графический процессор (GPU) от NVIDIA для повышения производительности параллельных вычислений. CUDA представляет собой набор инструментов и библиотек для работы с графическим процессором.
Если вы выбрали
CPU, дополнительно доступен переключатель:- Ограничивать CPU – ограничение процессорных ресурсов, выделяемых контейнеру с движком. При включении задайте количество используемых ядер CPU и номер ядра, начиная с которого будут выделяться ядра. Если переключатель выключен, контейнеру доступны все ядра машины.
Если вы выбрали
CUDA, дополнительно установите:- Кол-во используемых GPU – количество видеокарт, от 1 до 8. Если модель не помещается в VRAM одной GPU, используйте несколько видеокарт.
- Загруженность видеокарты, % – доля памяти видеокарты, которую может занять модель. Поле отображается только для моделей на движке vLLM.
- Лимит изображений – предельное количество изображений, которое модель обрабатывает за один запрос, от 1 до 20. Поле отображается только для моделей на движке vLLM, у которых есть дополнительные возможности, например, обработка изображений. На каждое изображение требуется около 3000 токенов контекста: если Размер контекстного окна меньше, чем нужно для заданного лимита, рядом с полем появится значок предупреждения с расчетом.
Для исполнителя агентских систем
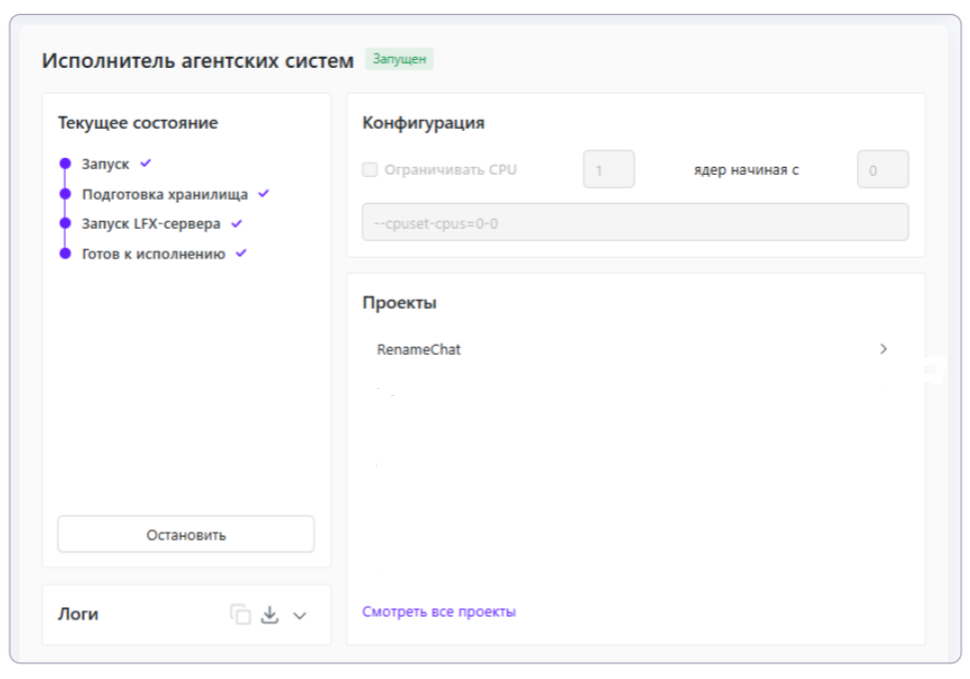
- Ограничивать CPU – переключатель, включающий ограничение процессорных ресурсов, выделяемых контейнеру исполнителя. При включении задайте:
- количество используемых ядер CPU;
- номер ядра, начиная с которого будут выделяться ядра.
Если переключатель выключен, контейнеру доступны все ядра машины.
В блоке Проекты отображается список проектов агентских систем, которые выполняются на этом исполнителе. Название проекта – ссылка на страницу проекта. Если проектов больше семи, ссылка Смотреть все проекты открывает полный список в отдельном окне.
Для RAG
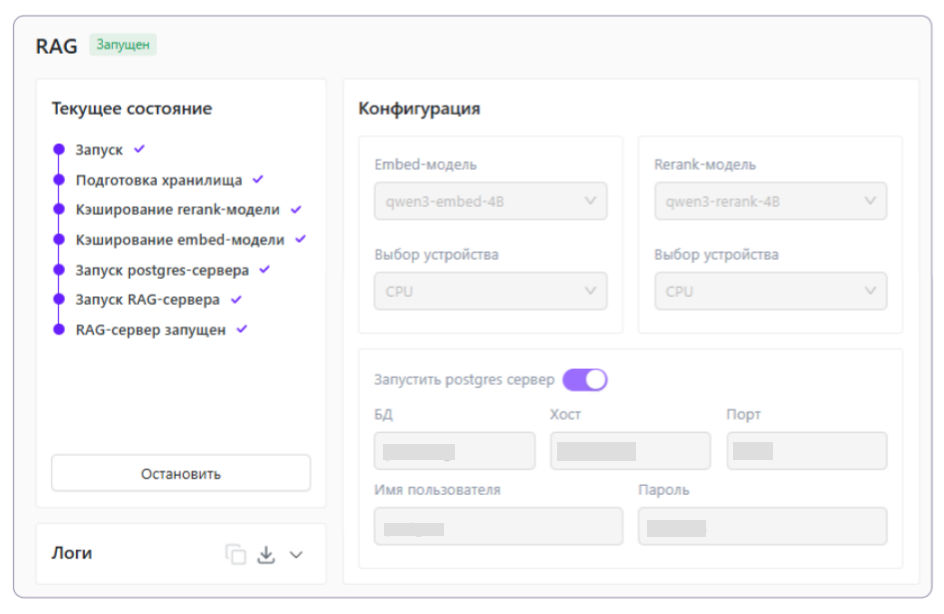
Embed- и Rerank-модели
- Embed-модель – модель для создания векторных представлений текста, выбирается из выпадающего списка.
- Rerank-модель – модель для повторного ранжирования результатов поиска, выбирается аналогично. Чтобы не использовать повторное ранжирование, выберите значение Не использовать.
Для каждой модели отдельно задайте Выбор устройства: CPU или CUDA.
Postgres-сервер
Для хранения и управления индексами данных используется база данных Postgres. Два сценария подключения:
- Автоматическое развертывание: включите переключатель «Запустить postgres сервер», система самостоятельно инициализирует локальный экземпляр БД с необходимыми параметрами.
- Внешняя база данных: при выключенном переключателе вручную заполните БД (название базы), Хост (сетевой адрес), Порт, Имя пользователя и Пароль.
Логирование
В нижней части панелей LLM, исполнителя агентских систем и RAG расположен блок Логи, который позволяет отслеживать технические процессы в реальном времени.
В блоке доступны кнопки для быстрого копирования содержимого логов в буфер обмена и скачивания лога в виде файла.
Как запустить и остановить модель
Сконфигурируйте модель и нажмите Запустить: начнется пошаговая инициализация (см. Стадии запуска выше). Когда все стадии отмечены галочками, статус сменится на Запущена. Если запуск завершился ошибкой, статус сменится на Ошибка. Наведите курсор на значок вопроса рядом со статусом, чтобы увидеть причину.
Во время запуска LLM, исполнителя агентских систем или RAG следите за виджетом мониторинга ресурсов в верхней панели. Он показывает, сколько CPU, GPU, RAM, VRAM и места на диске занято на машине. Если какой-то ресурс заполнен почти полностью, запуск может завершиться ошибкой. Например, при нехватке видеопамяти остановите другие компоненты на машине или выберите модель меньшего размера.
Чтобы остановить LLM-модель (например, для выключения машины или изменения настроек), нажмите Остановить и дождитесь смены статуса с Запущена на Бездействует.
Если запущенная LLM используется в проектах, на кнопке Остановить отображается оранжевый значок с подсказкой «Используется». Остановка такой LLM повлияет на работу проектов: навыки, которые от неё зависят, перестанут обрабатывать запросы. Какие проекты используют LLM, можно посмотреть в разделе NLP.
NLP
На панели NLP отображается таблица сервисов NLP-проектов, работающих на этой машине. Таблица доступна только для просмотра: сервис проекта настраивается и запускается в самом проекте, в разделе Использование.
Столбцы таблицы:
- Процесс – название конфигурации сервиса.
- Статус – текущее состояние сервиса. У запущенного сервиса рядом со статусом расположен значок Очистить очередь: он прерывает все ожидающие и выполняющиеся запросы к сервису, они завершатся ошибкой.
- Модель LLM – модель, с которой работает сервис, ее движок и устройство.
- Закреплена – отметка, если в настройках сервиса установлен флажок Закрепить эту модель.
- Проекты – проекты, которые используют сервис. Название проекта – ссылка на раздел Использование этого проекта.
Если на машине не работает ни один сервис, в таблице отображается «Модели не используются».
Умный OCR
На панели Умный OCR отображается таблица процессов проектов Умного OCR, которые выполняются или выполнялись на этой машине:
- Проект – название проекта.
- Процесс – тип процесса:
Обучение,Использование,АвтотестилиАвторазметка. Если процесс использования распознает текст механизмом ViT, рядом отображается метка ViT. - Статус – текущее состояние процесса.
- Модель – конфигурация использования, процесс обучения или авторазметки. Название является ссылкой на соответствующий раздел проекта.
- Распознавание текста – механизм распознавания текста: LLM-модель, используемая как ViT (с указанием движка и устройства), или
Tesseract.
Если на машине нет процессов Умного OCR, в таблице отображается «Модели не используются».
Что дальше
Перейдите к настройке проекта с типом Задачи NLP.